RAG sin tanto misterio: qué es realmente
Temas relacionados / Etiquetas
Entendiendo RAG: ¿qué es y cómo funciona?
Bueno, en pleno 2026 y, como no podía ser de otra forma, tenemos que hablar de algo relacionado con la inteligencia artificial. Y es que hoy en día, desarrollar las mismas aplicaciones que desarrollábamos hace un par de años ya no se ve con los mismos ojos. Las empresas, los clientes y las personas quieren integrar IA de alguna forma a sus sistemas, sitios web, aplicaciones, etc.
Y aunque pueda parecer muy complejo —porque créanme, cuando pensaba en esto solo me imaginaba algo súper difícil de hacer—, en realidad, algunos de los conceptos básicos son mucho más sencillos de lo que parecen. Claro está, todo varía según la complejidad que quieras darle y la cantidad de componentes que quieras o necesites añadir.
Vamos entonces a entrar en materia.
Una de las formas más comunes de integrar un modelo de IA con información propia es mediante algo denominado RAG.
Ojo aquí: RAG no es la única forma de implementar IA en nuestros sistemas. Existen diferentes enfoques y arquitecturas dependiendo de lo que queramos construir.
¿Qué es un RAG?
RAG son las siglas de Retrieval-Augmented Generation, que podríamos traducir como generación aumentada mediante recuperación o cualquier traducción similar que le encuentres.
Imagina que tenemos un sistema con información que queremos utilizar para responder las preguntas de nuestros usuarios. Puede ser información almacenada en una base de datos, documentos, archivos o cualquier otra fuente de información. El problema es que un LLM (Large Language Model), llámese Gpt, Sonnet, Deepseek, o cualquiera, no conoce automáticamente los datos de nuestro sistema.
Entonces, ¿cómo hacemos para que pueda utilizarlos?
Aquí entra RAG. La idea, a grandes rasgos, es bastante sencilla: cuando el usuario hace una pregunta, nuestro sistema busca información relevante en las fuentes que nosotros definamos. Esa información recuperada se entrega como contexto a la solicitud del LLM y, utilizando ese contexto, el modelo genera una respuesta en lenguaje natural. Es decir, no estamos haciendo que el modelo de forma literal "conozca" nuestra base de datos ni dándole acceso directo a ella. Lo que hacemos es recuperar la información que necesitamos y proporcionársela como contexto.
Ya tiene algo de sentido, ¿a que sí?
El flujo de un RAG
Entonces, sobre el papel, el flujo es bastante sencillo:
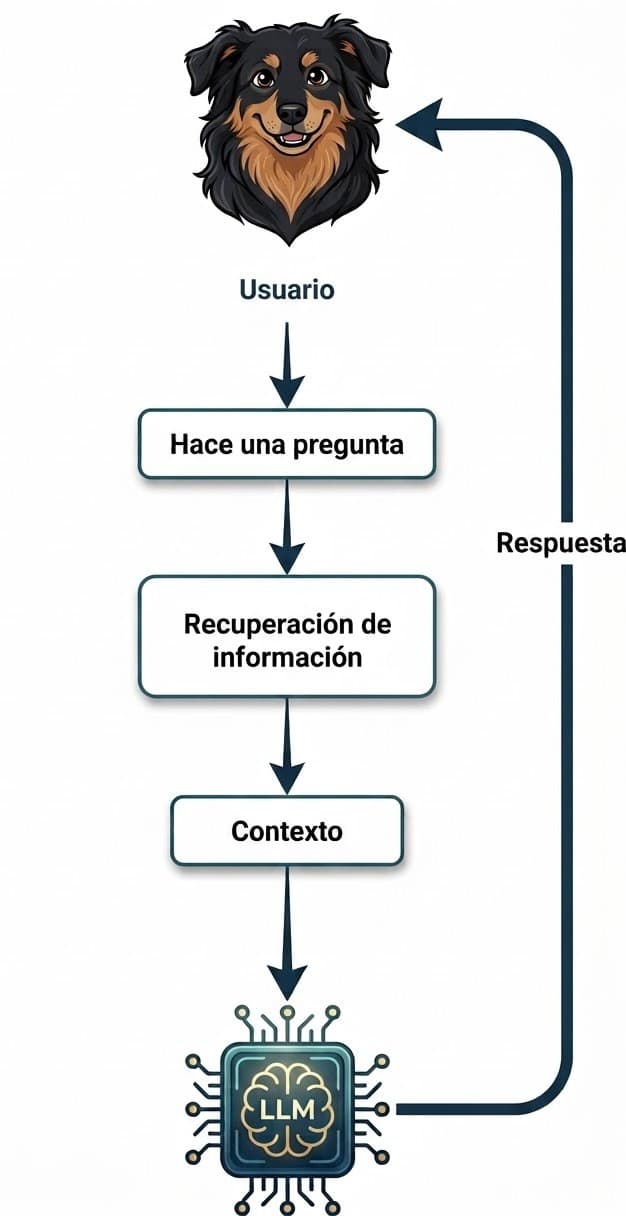
- El usuario hace una pregunta.
- Nuestro sistema utiliza algún mecanismo para recuperar la información que considera relevante.
- Esa información se incorpora al contexto que recibe el LLM.
- Finalmente, el modelo utiliza la pregunta y el contexto proporcionado para generar la respuesta.
La parte importante- está precisamente en cómo recuperamos esa información.
Y aquí es donde vamos a centrarnos en dos enfoques que veremos con más detalle en los siguientes posts:
- Búsqueda semántica
- Text-to-SQL
No son las únicas formas de construir sistemas de recuperación para RAG, pero son dos enfoques bastante diferentes y sirven para entender muy bien el problema.
¿Búsqueda semántica o Text-to-SQL?
Aunque ambos enfoques buscan obtener información para responder la pregunta del usuario, lo hacen de maneras bastante diferentes.
La búsqueda semántica intenta encontrar información que tenga un significado relacionado con lo que el usuario está preguntando.
Por otro lado, Text-to-SQL utiliza el LLM para interpretar la pregunta y generar una consulta SQL que luego podemos ejecutar sobre nuestra base de datos.
Entonces, tu dirás ¿pero cuándo uso cada una?
Pues, como casi siempre en desarrollo de software, depende del problema que queramos resolver.
Text-to-SQL
Imagina que tenemos una base de datos de videojuegos donde guardamos varios títulos, junto con sus categorías, años de lanzamiento, plataformas y una pequeña sinopsis.
Si el usuario pregunta:
"¿Cuántos juegos de acción hay registrados?"
o algo como:
"Recomiéndame juegos de acción que no sean tan antiguos."
Si tú fueras quien recibe estas solicitudes, estoy seguro de que podrías convertirlas en consultas SQL, ¿verdad?
Por ejemplo, la segunda podría traducirse en algo similar a:
SELECT title, release_date, category
FROM videogames
WHERE category = 'action'
AND release_date > '2024-01-01';
El LLM puede entender la pregunta, identificar que el usuario está buscando juegos de acción y generar una consulta que obtenga la información necesaria.
Esto es básicamente Text-to-SQL: utilizar un modelo para transformar una pregunta expresada en lenguaje natural en una consulta SQL que podamos ejecutar sobre nuestros datos.
Y aquí tenemos una buena ventaja: si la pregunta está relacionada con información estructurada, como cantidades, filtros, fechas, categorías, relaciones o agregaciones, SQL puede ser una herramienta muy potente para obtener exactamente los datos que necesitamos, y es mucho más rápido y también más familiar para nosotros como desarrolladores.
Pero también hay que tener mucho cuidado. Estamos dejando que un modelo genere consultas que posteriormente se van a ejecutar sobre nuestra base de datos. Por eso, NO debemos confiar únicamente en un prompt que le diga al modelo qué comandos puede o no puede utilizar.
Tenemos que aplicar controles adicionales como validar las consultas generadas y, dependiendo del caso, utilizar mecanismos que impidan operaciones que puedan modificar, corromper o eliminar información.
No queremos que una pregunta como:
"¿Cuántos juegos de acción tenemos?"
termine provocando un DELETE en la base de datos y posterior a eso tu despido de la empresa donde trabajas o un problema gigante con un cliente. Está genial para el meme de Tik Tok, pero en serio, implementa validaciones :)
Y es que parece obvio, pero cuando dejamos que un modelo genere consultas que vamos a ejecutar, la seguridad pasa a ser un factor al que debemos prestarle muchísima atención.
Búsqueda semántica
Ahora, imagina estas otras preguntas:
"¿Qué juegos me recomiendas para pasar un rato con mis amigos?"
o:
"¿Cuál juego sería el que más miedo me va a dar?"
Aunque podríamos intentar generar alguna consulta SQL para responderlas, probablemente no sería tan precisa y, en algunos casos, sería bastante complejo representar ese tipo de petición mediante consultas tradicionales.
Aquí es donde entra la búsqueda semántica. En lugar de intentar traducir directamente la pregunta a SQL, podemos buscar información cuyo significado esté relacionado con lo que el usuario está preguntando.
Para hacerlo, normalmente necesitamos convertir nuestra información en embeddings, que son representaciones numéricas del contenido en forma de vectores.
Por ejemplo, podríamos tomar las sinopsis de nuestros videojuegos, dividirlas en fragmentos más pequeños llamados chunks y generar un embedding para cada uno.
Después almacenamos esos vectores en algún sistema que permita realizar búsquedas por similitud (una base de datos PostgreSQL por ejemplo).
Cuando el usuario hace una pregunta, convertimos esa pregunta en un embedding y buscamos los vectores que sean más cercanos a ella.
De esta forma podemos encontrar información que aunque no utilice exactamente las mismas palabras que la pregunta del usuario, tenga un significado relacionado.
Por ejemplo, una sinopsis que diga:
"Un grupo de amigos debe sobrevivir a una criatura que los persigue durante toda la noche."
podría ser relevante para una pregunta como:
"¿Cuál juego sería el que más miedo me va a dar?"
aunque ninguna de las dos utilice exactamente las mismas palabras.
En estas situaciones es donde la búsqueda semántica tiene bastante sentido.
Pero...y entonces, ¿cuál usamos?
Obviamente, y como para todo en este ámbito, no existe una respuesta universal.
Si el usuario necesita consultar datos estructurados, como cantidades, fechas, filtros, categorías o agregaciones, Text-to-SQL encaja muy bien.
Si necesitamos encontrar información relacionada por significado o contexto, la búsqueda semántica puede ser una mejor opción. No tienes que elegir una sola, depende de tu sistema y tu tipo de datos es probable que llegues a implementarlas juntas, incluso con algún otro tipo de estrategia.
Lo importante es entender que RAG no consiste simplemente en conectar un LLM a una base de datos, y que tampoco es una cosa súper compleja e imposible.
RAG es el patrón que nos permite recuperar información relevante desde una fuente externa y utilizarla como contexto para generar una respuesta, así que, si te das cuenta, es como si cogieras un trozo de información, entraras a Chat-GPT, le hicieras una pregunta y le dijeras "Oye, responde basado en esta info que te estoy dando" y le pegas el trozo de texto, a grandes rasgos en eso, pero programado, la parte que cambia es cómo recuperamos esa información.
En el siguiente post vamos a ver más a detalle como implementar una búsqueda semántica, desde los embeddings hasta la búsqueda vectorial y la generación de la respuesta, con algunos ejemplos de código sencillos.